
文献集锦 | 综述:植物基因组重测序与群体基因组学的现状与展望
2023年7月,中国农业科学院深圳农业基因组研究所在Molecular Plant上发表了研究成果,综述了群体基因组重测序研究的最新进展及其对作物育种的影响。
文章题目
Plant genome resequencing and population genomics: Current status and future prospects
第一作者:Bo Song, Weidong Ning
通讯作者:Shifeng Cheng
通讯单位:中国农业科学院深圳农业基因组研究所
杂志:Molecular Plant
影响因子:27.5/Q1
文章链接:
https://doi.org/10.1016/j.molp.2023.07.009
研究背景
虽然重测序物种跨越了陆地植物的整个范围,但分类学上的差距仍然存在,且大多数植物基因组重测序研究都集中在作物上(如谷物和豆类),未来需努力填补物种空白,以进一步了解植物基因组进化。这些已测序种质来自全球纬度和海拔跨度较大、环境因素(如温度、降水和太阳辐射)变化较大的地区,为更广泛地研究植物基因组对环境的响应提供了可能。然而,大多数基因分型数据集是不可访问的,这种缺乏可访问性的情况阻碍了这些数据集的二次利用,并导致种质的重复测序。
研究意义
本文综述了植物基因组重测序的研究进展,以及在作物驯化和选择、植物与环境相互作用、基因组与表型关联等方面获得的见解,并提供了与各种性状相关的候选基因库,可用于未来的研究和应用。
全基因组重测序:从模式生物到分类多样性
随着DNA测序成本的不断降低,全基因组重测序项目发展迅速。迄今为止,已经报道了187种植物的基因组重测序。随着鹰嘴豆基因组项目的完成,葡萄、水稻和大豆的重测序数量峰值分别达到3525个、3010个和2898个,这些大规模重测序工作促进了包括稀有等位基因在内的近乎完整的SNP图谱的生成。最初,基因组重测序研究主要集中在模式植物和小型二倍体基因组作物,如水稻和番茄,具有更大和更复杂基因组的植物重测序面临着更高成本和高计算要求的挑战。然而,尽管存在这些局限性,在参考基因组序列完成后不久,对具有大而复杂基因组植物的群体基因组研究就出现了。例如,在2018年发表了六倍体小麦(Triticum aestivum)参考基因组后,2019年和2020年发表了几项小麦重测序研究。随着成本的降低,目前正在构建非主流作物的基因组和泛基因组参考资料,包括高粱(Sorghum bicolor L.)、鸽豆(Cajanus cajan L.)和香蕉(Musa spp.)。随着能够管理复杂基因组(包括杂合子和多倍体基因组)的更先进测序技术和组装算法的发展,有望进一步增加重新测序物种的数量,并发表更多高质量的参考基因组组装结果。
虽然已经为陆生植物系统发育树上的物种建立了参考基因组,但重测序研究主要集中在少数几个目和科中。在187个重新测序的物种中,38%属于4个科,其中12%(23个)属于禾本科,11%(21个)属于豆科,7%(13个)属于十字花科,8% (14个)属于蔷薇科。如果考虑到每个物种的重测序入选种的数量,就会发现基因组重测序研究的规模受物种的经济重要性影响很大,而且明显偏向于作物,尤其是豆科和芸香科作物。目前仍有49个目没有物种得到重测序,虽然其中23个目中的一些物种已有参考基因组,但其余26个目仍缺乏参考基因组。
裸子植物曾一度主宰地球陆地,但如今只有四个谱系:针叶目、苏铁目、银杏目和买麻藤目,约有1000个物种。从这些裸子植物中获得的基因组数据集为进一步了解植物基因组进化和适应提供了机会,如通过对545个银杏基因组的测序,能够深入了解该物种在更新世冰川时期的种群动态,揭示了与气候变化相关的多轮扩张和缩减。通过研究分布广泛的药用植物可以丰富对分类多样性的探索,药用植物参考基因组正在迅速积累,可以预期基因组重测序研究也会出现类似增长。Ren等人(2021 年)最近对大麻基因组进行了重测序,从而鉴定出了与药用型和工业用途类型栽培品种分化相关的基因。
非洲孤儿作物联盟(AOCC)成立于2011年,旨在为101种非洲孤儿作物生成参考基因组汇编,并对每种作物的100份材料进行重测序(http://africanorphancrops.org/)。虽然AOCC的重点是农作物,但其中许多物种并不属于主要作物科。AOCC的目标植物包括28目45科的物种,其中19种尚未进行重测序。因此,该项目的完成不仅将推进这些孤儿作物的研究和育种,而且有助于填补基因组重测序工作的分类空白。
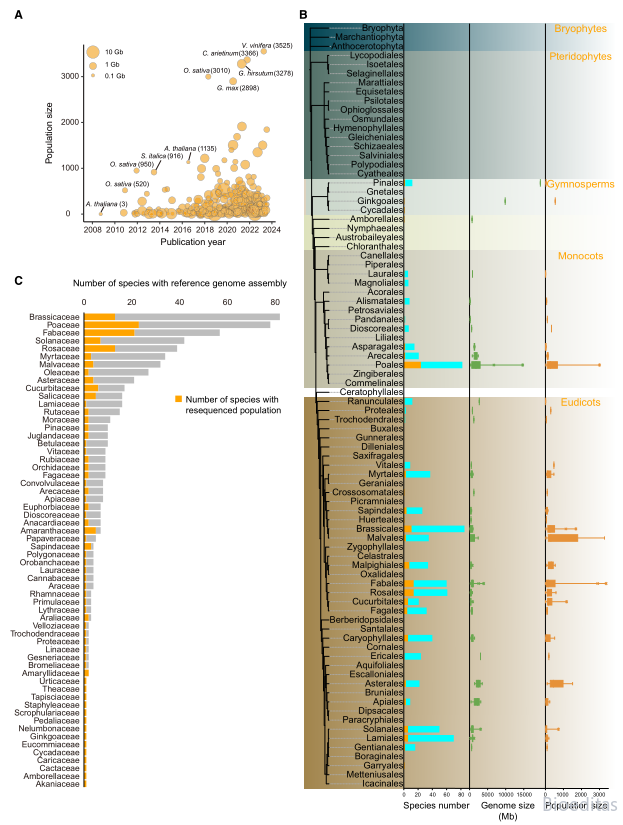
▲重测序植物种群的时间进程及系统发育分布
豆类和谷类的共同驯化
除南极洲外,共从各大洲的163个国家获得了54,413份种质资源。种质收集中心的分布与作物植物起源的瓦维洛夫中心一致,其中的八个中心完全一致,西非和美洲两地在其他研究中被认为是水稻的驯化中心。禾本科植物和豆科植物的采集地点有很大的重叠,这意味着它们是共同驯化的。通过分析种群的SNP数据集,可以推断出驯化中心和传播路线。
通过这种方法,重新测序计划报告了28种作物的驯化中心,包括6种谷物、6种豆科植物、6种蔬菜和10种水果。研究结果表明,谷类和豆类作物的驯化往往相互交织,如水稻、小米和大豆是在中国驯化的,而小麦、大麦、鹰嘴豆和扁豆则是在新月沃地驯化的;撒哈拉以南非洲是高粱、珍珠粟和绿豆等作物的驯化中心,而玉米、菜豆和利马豆则是在中美洲驯化的。这些驯化中心代表了驯化不同作物的早期农业社区。谷类和豆类作物同时被驯化也可能是因为它们的营养互补性,谷物是主要的碳水化合物来源,但蛋白质含量较低,而豆类含有丰富的蛋白质和矿物质;此外,豆类富含赖氨酸等必需氨基酸,但蛋氨酸、胱氨酸和半胱氨酸等含硫氨基酸含量较低,而谷物富含含硫氨基酸,但缺乏赖氨酸。谷物和豆类的综合食用很可能为当地居民提供了均衡营养。
驯化过程中的基因选择
在驯化过程中,对落粒性低和花序结构增强等性状的选择导致了核苷酸多样性的降低。通过对野生种群和栽培种群的比较分析,可以发现驯化过程中的选择信号,并鉴定育种改良品种所需的基因。Huang等人(2012a)分别在籼稻、粳稻和杂交稻群体中鉴定了60、62和55个驯化相关位点,包括与落粒性(sh4, qSH1)、稻壳颜色(Bh4)、果皮颜色(Rc)、分蘖角度(PROG1)、籽粒宽度(qSW5)和籽粒质量(Waxy)相关的已知驯化基因。在非洲水稻的驯化过程中,PROG1也显示出强选择的证据,表明亚洲和非洲之间的驯化趋同。其他谷类作物,如小麦、玉米、薏米、珍珠粟和谷子的驯化,也涉及到与植物结构、穗形态、落粒性、谷粒宽度或开花有关的基因选择。
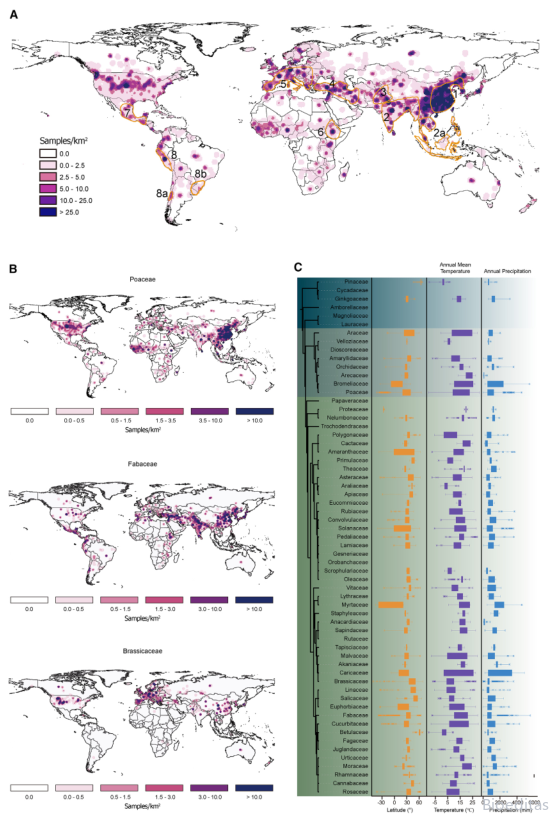
▲种群重测序种质收集点的地理分布和环境背景
在小麦中选择的基因包括控制非脆轴和碎裂的基因(如TtBtr1-A和TtBtr1-B)以及参与昼夜节律途径和开花的基因。大约7.6%的玉米基因组在驯化过程中经历了选择,这些区域包括与开花、产量、氮动员、种子萌发和赤霉素生物合成潜在相关的基因。豆科植物基因组的选择主要针对与豆荚开裂、种子大小、种子发育和萌发、胁迫反应和开花有关的基因,如在大豆基因组中检测到的选择区域与含有负责豆荚开裂基因的数量性状位点(QTL)重叠。对美国农业部(USDA)收集的1000多份大豆重测序系的研究也发现,在大豆驯化过程中,基因含量和平均基因数量显著减少。
这些数据已被重新用于定义影响重要农艺性状(如蛋白质含量和油脂产量)的基因家族特征。水果和蔬菜作物的驯化过程中,与口味、风味、营养和抗病性相关的基因受到了青睐:桃的驯化与糖和酸含量有关;叶菜类蔬菜的驯化偏好与叶片表面纹理、叶基部形状和叶柄颜色等叶片性状相关的区域,如菠菜基因组中的选定区域含有参与角质蛋白组装的基因,莴苣中的选定区域与控制叶片形态的QTL重叠。
驯化过程中筛选出的基因是作物进一步改良的目标,特别是因为这些基因与理想农艺性状的QTLs始终保持重叠,其中一些基因已在育种计划中进行了二次选择。然而,这些区域内的许多基因仍缺乏功能特征描述,因此需要进一步研究。
基因组学对环境适应的响应
随着气候变化对农业的影响越来越大,迫切需要培育出适应新的、更加多变气候的作物。了解整个物种的多样性有助于确定合适的适应性等位基因,跨越多种生境的重测序数据集可为了解基因组如何应对不断变化的环境提供宝贵的见解。为了说明环境变化,作者们研究了来自 Worldclim (https://www.worldclim.org/) 的气候数据,这些数据显示了这些地点年平均气温、降水量和太阳辐射的范围,丰富的地理和生物气候多样性有助于研究基因组对不同环境的反应和适应性基因的鉴定。
开花时间是与植物适应性相关的重要表型;与非生物胁迫反应相关的基因是作物育种的宝贵资源,也是一个广泛研究的课题,如耐热、耐寒基因等;植物适应太阳辐射的遗传机制的探索通常涉及青藏高原等高海拔地区的资料研究;植物适应土壤肥力的遗传机制,特别是与特定土壤类型和养分供应有关的机制,对于环境适应相应研究来说也至关重要。
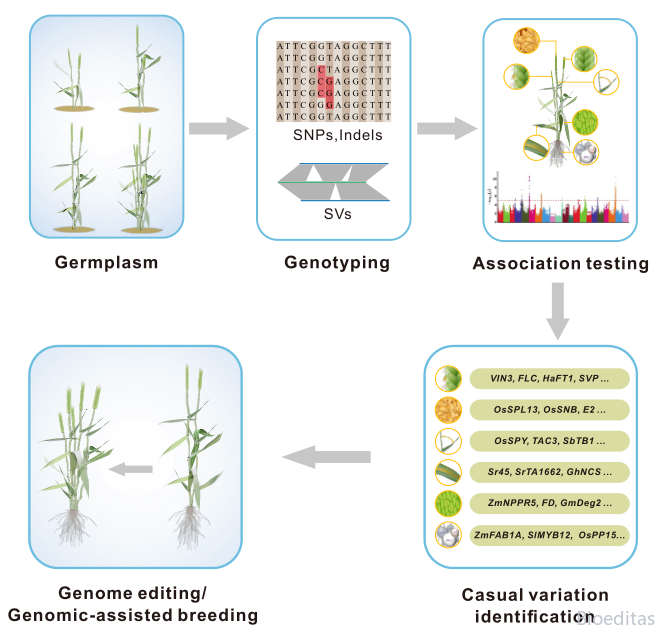
▲植物育种中群体基因组学方法的示意图
基因组-性状关联研究
DNA重测序技术的进步使得农作物中SNPs的快速发现成为可能,从而有助于鉴定与各种重要性状相关的基因或位点,从而加深我们对这些农作物的了解并加速其育种工作。通过全基因组关联研究(GWAS),与特定性状相关的区域已被确定。除了与气候适应性相关的基因位点外,据报道还有几个基因组区域与田间性状有关,如NUE、产量成分和代谢物含量。从38种作物中共鉴定出赋予367种表型的8332个位点,其中6573个位点与257种田间性状相关。研究人员分析了四大类表型,即产量、植株结构、对生物和非生物胁迫的耐受性以及代谢物多样性。
基因组辅助育种
通过基因组重测序研究鉴定基因组变异为育种和作物改良提供了宝贵的资源,这些DNA序列变异可以用来引入特定的等位基因、预测杂交性能,并设计更有效的育种策略。例如,在低氮和中氮条件下,将OsTCP19单倍型H(OsTCP-H)引入两个水稻优良品种,可增加分蘖数;Varshney等人(2021 年)对 3000 多个鹰嘴豆品种进行了重测序,发现了24个一致且稳定的优良单倍型,这些单倍型在 80% 的育种品系中不存在,并帮助选择了56个供体品系用于育种。
重测序数据有助于预测杂交性能,一个用于预测珍珠粟产量的模型确定了170个有希望的杂交组合,其中11个组合的表现有所改善,159个组合显示出了未来改善的潜;使用GWAS衍生的SNPs训练的模型能够预测菠菜的白锈病抗性,仅用40个SNPs就实现了高于0.75的相关性;在最近的一项玉米研究中,环境变量被整合到模型中,以准确预测欧洲不同条件下的玉米产量。Wei等(2021b)开发了RiceNavi,这是一个由三个主要模块组成的原位育种系统:RiceNavi-qtnpick,-Sim和-SampleSelect。该系统使样本选择、育种设计和优化原位,可在短时间内精确导入目标基因型,同时减少连锁阻力。尽管RiceNavi的强大功能和效率已在水稻中得到验证,但仍需针对其他作物开发更先进的系统。植物基因组重测序数据为训练性能预测模型和开发先进的原位育种系统提供了具有相当价值的基础资源,可大大加快作物育种计划。
结语和展望
植物种群基因组学的新时代
随着高通量 DNA 测序成本的降低,大规模群体基因组研究激增。早期新一代测序(NGS)平台的读长限制促使群体研究主要依赖于SNP变异,虽然一些研究采用了识别SV的方法,但要从NGS数据集中准确检测SV仍具有挑战性。目前,更先进的DNA测序技术为SV特征描述提供了解决方案,PacBio HiFi和Oxford Nanopore GridION的长读DNA测序技术已被用于构建包括大豆、小麦、水稻、大麦、番茄和马铃薯在内的几种作物的泛基因组。这些研究标志着基因组研究新时代的开始。长读基因组重测序深入揭示了SVs的进化和作用,而短读测序无法充分解决这些问题。
长读DNA测序的应用使得基于图谱泛基因组的构建成为可能,它可以取代植物基因组研究中的单一参考基因组,捕捉线性参考中经常忽略的遗传性。由于变异识别依赖于参考基因组,因此一旦有了图形泛基因组参考,就必须重新评估群体重测序数据。一种方法是将NGS读数映射到图谱基因组参考文献并识别变异,为此开发了包括GraphTyper、GraphAligner和HISAT2在内的几种工具,虽然与线性参考基因组分析相比,基于图谱的映射和变异调用通常速度较慢且需要更多内存,但新开发的Giraffe可以准确地将NGS读数映射到图谱基因组并识别SNP、Indel等变异,其速度可与单个线性基因组相媲美;另一种解决方案是将单基因组转换为图形泛基因组,这种方法效率更高,所需的计算资源也更少,通过这种方法可以将从单基因组中识别出的SNP重新定位到泛基因组坐标系中。然而,这种方法可能不适合使用短读测序难以检测到的SV。在最近的一项人类研究中,长序列测序被用于对3000多个个体进行重新测序,虽然目前长读测序的高成本限制了其在植物研究中的群体规模应用,但成本的降低将使长读程测序逐渐成为群体研究的标准。
从长读数中识别的变异更能解析高度重复基因组中的SV、插入和缺失,在某些情况下还有助于直接检测甲基化核苷酸,如m6A、5mC和5hmC。基因组中的表观遗传变异可导致巨大的表型变化,而长读技术的应用有可能识别出表观遗传修饰的等位基因,这些等位基因赋予的性状不能完全用DNA序列变异来解释。新兴技术为植物种群研究带来了希望,尽管它们的大规模应用目前会受到经济限制。
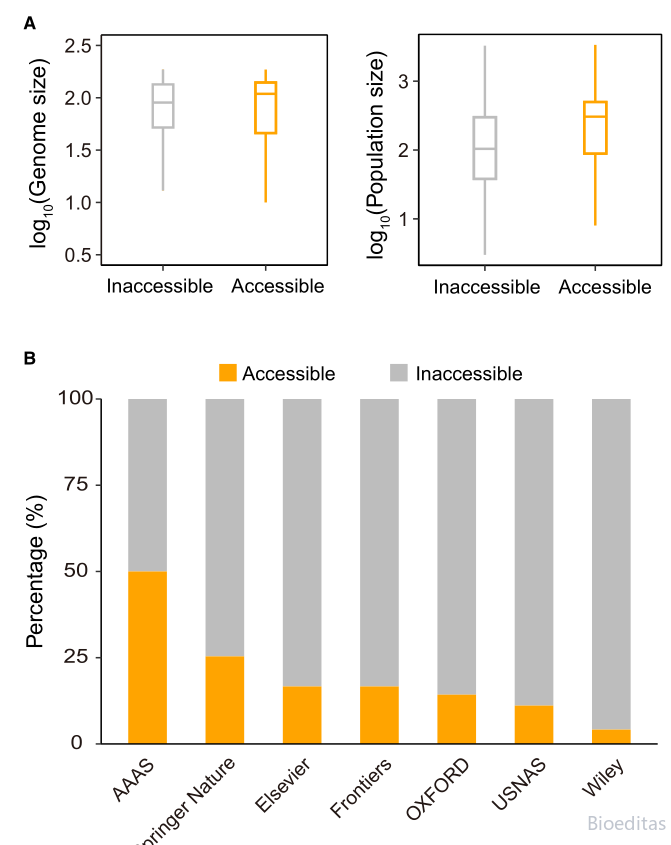
▲植物基因组变异数据集的可及性
需要更大的数据可访问性
事实证明,与研究界共享数据是有益的,通过汇编和二次分析公共数据开展的许多杰出研究为基因组进化和转录调控提供了真知灼见。群体基因组数据集有很大的潜力被其他研究人员用于不同的目的,如meta-GWAS和未注释的开放阅读框的识别。然而,群体基因组数据集的二次分析相对罕见,部分原因是访问这些数据集的困难,这可能比访问基因组或转录组数据集更具挑战性。
尽管大多数期刊要求或鼓励共享基因组数据,但许多研究中基因分型数据的获取仍然受到限制。对期刊数据共享政策的调查显示,约有36%的期刊要求共享基因组数据,其中12%的期刊规定数据共享是发表论文的条件之一。
为了了解基因分型数据集可访问性差的问题,研究人员比较了有基因分型数据集的研究和没有基因分型数据集的研究在研究人群和基因组大小方面的差异。出乎意料的是,尽管上传大型数据集可能存在困难,但来自较大基因组和较大种群的数据集比小型数据集更容易获取。这一与发现相反的结论表明,传输大型数据的困难并不是阻碍基因分型数据集共享的主要因素。有两个原因可以解释这一结果:首先,大多数大规模种群研究都是国际合作,涉及来自不同国家的许多研究所,其中数据生成和共享是这些项目的主要目标之一;第二,大规模种群研究更有可能发表在以数据共享为发表条件的顶级期刊上,研究显示数据可及性与出版商之间存在很强的相关性。
为了更好地促进对这些数据的进一步分析,建议在提交的数据集中包含以下信息:(1) 物种描述,如名称和分类;(2) 基因组描述,包括倍性和基因组大小,以及参考基因组的版本;(3) SNP识别和筛选所使用的工具和参数;(4) 有关样本的详细信息,如采集地点和育种状况(野生种、陆生种或优良栽培种);(5) 原始SNP数据集,以备未来用户使用自定义参数重新筛选SNP时使用。
总之,尽管群体重测序数据的数量和质量都在迅速提高,但对现有数据集的分析仍然不足,未来的研究需要对这些数据集进行更全面的分析和更深入的挖掘。大规模植物群体基因组数据集的积累为进一步了解植物基因组进化和适应提供了前所未有的机会。植物基因组研究的未来方向可能包括利用这些数据集进行元分析,以进一步了解植物基因组的进化和对环境变化的响应。重新测序的植物基因组在发育树上的广泛分布为分析植物基因组的种内和种间进化提供了便利,而相关数据集的不断积累将进一步加速这一分析,对可公开获得的基因组数据集进行二次分析对于提出与植物基因组进化相关的新见解和新假设大有希望。为促进此类分析,应通过鼓励更多的公开共享来消除访问这些数据集的障碍,这不仅对再现已发表的分析至关重要,而且有利于减少冗余工作,并通过数据汇编促进二次分析。

